

2026年のAIプロンプト最適化:複雑さのコストを新研究が検証
著者 エマニュエル・アブ・シャブケ、創業者兼編集者 · AIQuickPrompt編集チームによる監修済み · 運営者について
新しいプロンプト最適化研究は、複雑なAIプロンプト最適化ツールに費用をかける前に、まず簡単な方法を試すよう提案しています。2026年11月17日にarXivへ投稿されたプレプリントは、候補を生成して選ぶ方法と2種類の高度な最適化手法を比較しました。一部の構造化タスクでは、測定コストを抑えながら同程度のスコアを報告しています。一方、自由形式や推論を要する一部の作業では複雑な手法が優位でした。同じタスクと予算で比べましょう。
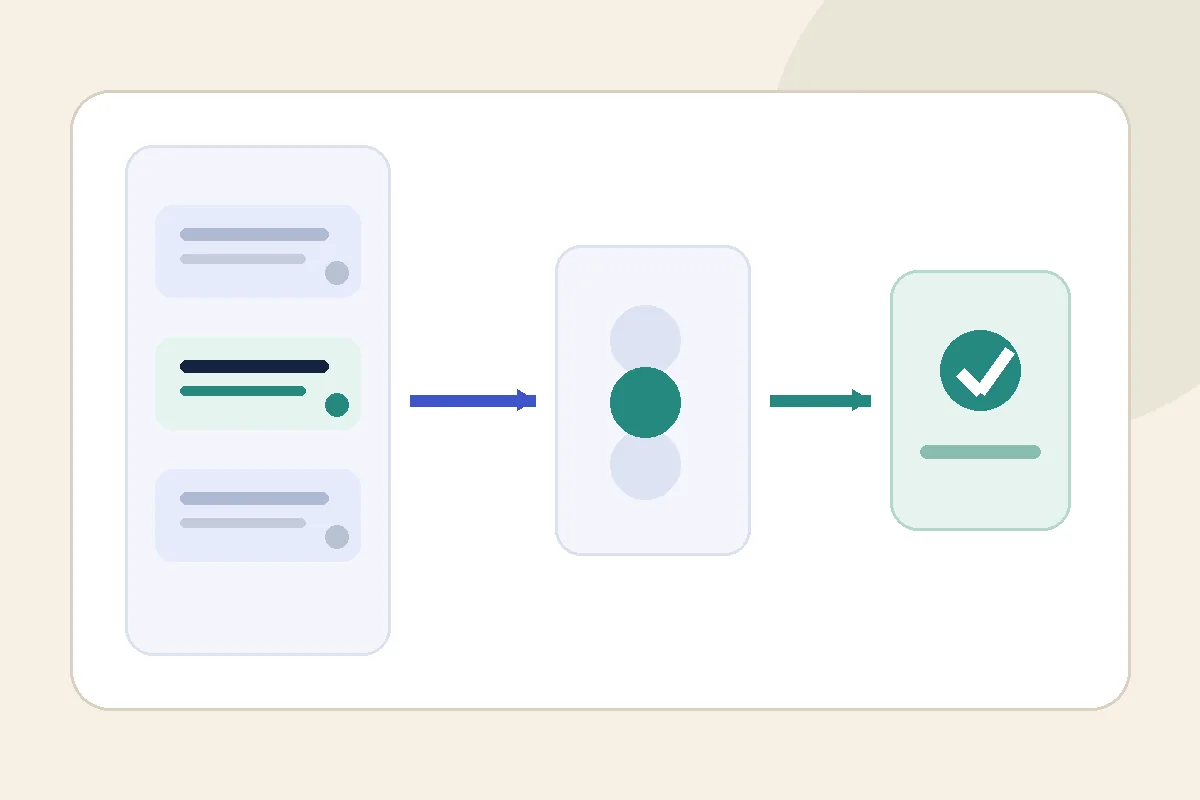
新しいプロンプト最適化研究で検証されたこと
11月17日のarXivプレプリント「Simplicity Goes Far」は、自動最適化の成果が専用の仕組みによるのか、候補を生成して最良を選ぶ共通ステップによるのかを検証します。DCPSは簡易な比較手法です。例をもとにモデルが候補を作り、検証用データで採点して最良を選びます。学習済みの方策更新、内省、進化的探索は使いません。
簡単なAI最適化手法が互角だったケース
分類タスクでは、DCPSはStablePromptとの差が0.5ポイント以内で、測定コストは約3分の1でした。GPT-4.1-miniを使うDSPyシステムでは、GEPAと同等のマクロ精度を55%少ない実行回数、平均32%低い測定APIコストで達成しました。これは研究の設定内の結果であり、節約を保証しません。一部の自由形式・推論タスクでは高度な手法が優位でした。
自分の作業でプロンプト最適化を試す方法
実際のタスクを代表する例を使い、AI最適化ツールを簡単な基準と比較します。モデル、候補数、テストデータ、支出上限をそろえます。作成用データと評価用データを分け、品質、費用、呼び出し回数、失敗、再現性を記録します。
- 簡単なプロンプトと代表的な例から始める。
- 決めた予算内で候補を少数生成し、採点する。
- 候補作成に使っていない例で最終候補を評価する。
- 品質、コスト、呼び出し回数、再現性を比べて選ぶ。
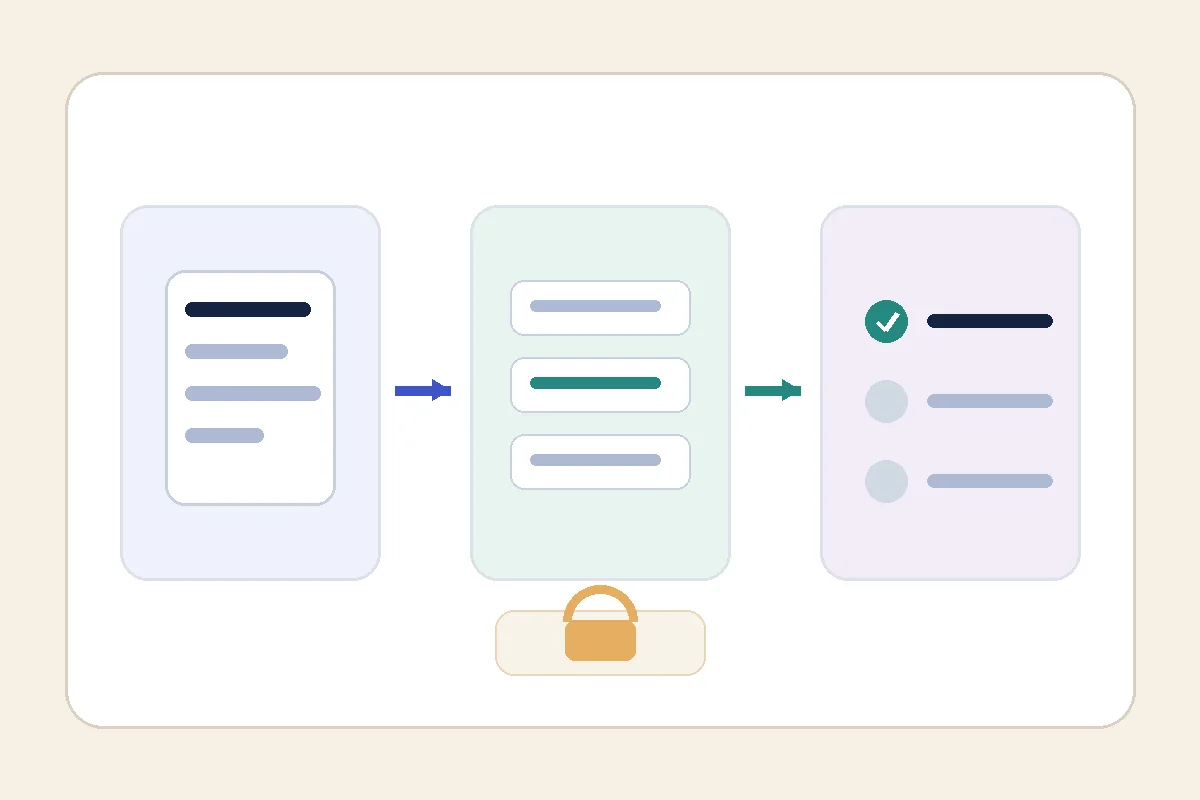
最適化ツールを比べるテンプレート
各手法でモデル、例、予算をそろえてこの評価票を使います。簡単な方法が勝った場合も記録しましょう。
タスク: {{task}}
モデルと設定: {{model}}
比較する方法: {{baseline_and_optimizer}}
開発用の例: {{development_examples}}
評価用の例: {{test_examples}}
採点基準: {{rubric}}
費用上限: {{budget}}
スコア、費用、呼び出し、失敗、再現性を記録
判断: {{decision}}
このプロンプトエンジニアリング研究が証明していないこと
これは新しいarXivプレプリントであり、すべての最適化ツールが本番で同じように動く証拠ではありません。結果はモデル、データセット、実装、予算に左右されます。簡単な基準との比較は研究設計から得られる提案で、AIQuickPromptが独自に測定した結果ではありません。